顯示具有 網路 標籤的文章。 顯示所有文章

2020-04-23

GoDaddy 無厘頭請款事件

我沒有作電話錄音,以現在的標準來說可能算空口無憑。只能說我會對以下的陳述負所有的法律責任。

TL;DR

  • 在沒有登入的情況下,GoDaddy 莫名產生購物內容並嘗試請款(因為信用卡驗證碼錯誤而請款失敗),GoDaddy 目前無法解釋這個狀況。
  • 若在 GoDaddy 綁定的信用卡,最好開啟刷卡消費通知,以防上述事件發生並請款成功。

事發經過

我在 GoDaddy 有購買兩個 domain,有開啟綁定信用卡自動續訂,上一次自動扣款日是 2019 年 8 月,信用卡應該都是同一張沒有因為過期換過。

2020/4/23 19:3x,手機收到信用卡銀行的兩封簡訊,有一筆 1923 元的請款授權失敗。

20:0x,看到手機簡訊,打電話到信用卡銀行,銀行方說有五次授權失敗的紀錄,請款方是 GoDaddy。

20:3x 上 GoDaddy 的網站查看訂單紀錄,依然是兩個 domain。但是發現購物車內有五筆預計購買的 domain(都是 c 開頭的 .com),估算金額是 18xx 元。

打電話到 GoDaddy 台北客服(02-77039087),開始了漫長的對話與等待… 概要如下:

  • 我最近的登入紀錄依序是 2020/4/23 20:3x 兩筆、再往前就是 2019 年年底
  • GoDaddy 有信用卡嘗試請款失敗的紀錄,但是客服說只有紀錄日期,沒有紀錄時間(喵的,誰相信系統會這樣設計),但是他們願意相信我所提供授權失敗時間。

綜合以上兩點,GoDaddy 無法解釋是誰在進行購物結帳的動作,因為請款時間是 19:3x,在請款時間之前的登入紀錄得回溯到 2019 年底。

然後,**GoDaddy 甚至也無法解釋為什麼會請款失敗。**按照信用卡銀行的說法,都是驗證碼錯誤所以授權失敗。但是按照 GoDaddy 客服人員的說法,因為有設定續訂、有給信用卡資訊(含驗證碼),理論上購物車在結帳請款時會沿用、也就是說不會再要求輸入一次驗證碼,所以理論上會請款成功才對… (至於 GoDaddy 操作流程上是不是真的不需要再次輸入驗證碼,我就沒有自己嘗試了)

無法總結的總結

GoDaddy 承認我所回報的狀況,但是他們目前無法提出任何解釋。唯一能給的建議就是要我換掉各種密碼、加上二階段認證(如果真的是密碼被 try 那事情還簡單一點,問題就不是帳號被駭阿)。客服只能承諾說查明真相會發個 email 告訴我,至於需要多久就不會保證;如果後續我要追問進度,只要告知客服人員我的客戶編號、以及我在哪個時間打過電話就可以。

所以呢… 我覺得還是趕快把信用卡的請款簡訊通知打開,然後換到 Google Domains 比較實在…

附錄

簡單 Google 了一下,發現近期也有人( https://noter.tw/ )遇到類似案例,一併 memo 於此:

2011-07-02

Source Multiplayer Networking [下]

輸入預測
前提假設是:有一個玩家的網路延遲為 150ms,然後開始往前移動。按下 +FORWARD 鍵的訊息儲存在一個 user command 當中,然後送到 server。user command 就會用移動的程式碼處理,玩家的角色也會在遊戲世界當中往前移動。這個遊戲世界狀態的改變,會在下一個 snapshot 更新時送給所有的 client。因此,玩家在開始行走之後 150ms 才會看到移動的變化。這種延遲狀況適用於所有玩家的行為,例如移動、武器射擊等,網路延遲越嚴重、這個狀況就會更嚴重。

玩家之間輸入與對應視覺回饋的延遲,造成一個奇怪且不自然的感覺,使得很難移動或是精準地瞄準。client 端的輸入預測(設定值 cl_predict 1)是消除這種延遲、使玩家感覺動作是即時的一種方法。與其等待 server 更新自己的位置,還不如 client 直接預測自己所下 user command 的結果。因此,server 處理 user command 的程式碼與規則,現在改由 client 端照樣處理。做完預測後,client 端的玩家會馬上移動到新的地點,但對 server 來說,那人仍然在老地方。

150ms 後,client 會收到 server 傳來的 snapshot,當中包含了之前預測 user command 產生的改變。然後 client 比較 server 計算的位置跟自己預測的位置,如果它們的值不相同,就會產生預測錯誤。這表示 client 在處理 user command 時沒有其他 entity 或是環境正確的資訊。client 就必須校正自己的位置,因為 server 有最終決定權可蓋過 client 端的預測值。當 cl_showerror 1 啟動,預測錯誤發生時 client 端就看得到。預測錯誤的校正會相當明顯,client 端看到的畫面也會亂跳。在一個較短的時間當中逐步修正錯誤(設定值:cl_smoothtime),可以較平滑地解決這個問題。平順預測誤差的功能也可以透過設定 cl_smooth 0 來關掉。

只有在 client 端與 server 端都知道同樣的規則以及物體的狀態,才有辦法預測物體的行為。但通常並非如此,因為 server 通常會比 client 知道更多物件資訊。client 只會看到一小部份的遊戲世界、以及僅夠繪製物件的資料量。因此,只能對 client 端自己控制的玩家、武器作預測。在這一點上,正確地預測其他玩家或是物體之間的交互作用,是無法辦到的。

lag 補償
在 Source 的 SDK 中可以看到 lag 補償與 view interpolation 的所有原始碼
假設一個玩家在 client 端時間 10.5 的時候開槍打一個目標。開槍的訊息會裝在一個 user command 當中,然後送到 server 去。當這個封包在網路上傳輸時,server 持續運作遊戲世界,所以目標可能移到不同的位置。這個 user command 在 server 時間 10.6 的時候到達,但即使玩家已經確實瞄準這個目標,server 還是可能會判定沒有命中。可以藉由 server 端的 lag 補償(設定值:sv_unlag 1)來校正這個誤差。

lag 補償系統會保留現在所有玩家過去一秒位置的歷史紀錄(可以用 sv_maxunlag 來設定間隔長度)。如果 user command 被執行到,server 會用下面的公式預測這個 command 是什麼時候執行的:
command 執行時間 = server 目前時間 - 封包往來時間 - client 端 interpolation
然後 server 會把所有玩家——也僅限玩家——移回 command 執行時的位置。這樣 user command 執行時,命中偵測就會正確。而在 user command 執行完後,玩家就會恢復到原來應該在的位置。
注意:因為算式中包含 entity interpolation,所以拿掉 entity interpolation 可能會導致預期外的結果。
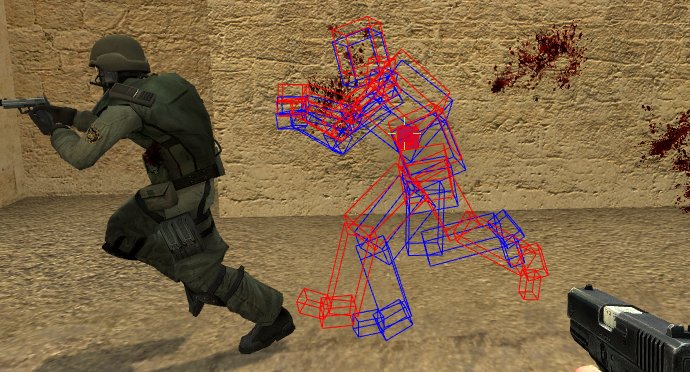
在 listen server 上,你可以設定 sv_showimpacts 1 來看到 server 與 client 不同 hitbox:


上頭這畫面是在一個用 net_fakelag 設定 200ms 延遲的 listen server 上擷取下來,此時 server 剛剛確認命中。 紅色 hitbox 顯示 client 在 100ms 之前看到的目標位置。在那之後,目標持續往左移動,直到 user command 到達 server。在 user command 到達後,server 用 command 執行時間作估算,將目標位置還原成藍色 hitbox 的地方。server 計算射擊的軌跡、確認擊中(client 看到噴血的效果)。

client 跟 server 的 hitbox 不會完全相符,這是因為時間測量產生的些微誤差。對於快速移動的物體來說,即使只是幾 ms 的差別,也會導致幾英吋的誤差。多人遊戲中的命中檢測並沒有辦法達到 pixel 層的完全吻合,精準度的限制在於 tickrate 以及物體移動的速度。增加 tickrate 會提昇命中檢測的精準度,但需要更多的 CPU、記憶體、以及 server 與 client 之間的網路頻寬。

講到這裡,有個問題就浮現了:為甚麼 server 上的命中檢測這麼複雜?往回追溯玩家位置與命中確認的精準度誤差,可以在 client 端以 pixel 等級的精準度處理得更輕鬆。client 端只要告訴 server 哪個玩家在哪裡被打中的「擊中」訊息就可以了。不過我們不能容許這種簡化的想法,因為遊戲 server 不能在這類重要的判斷上相信 client。即使 client 很「乾淨」、並有 Valve Anti-Cheat(VAC)的保護,但封包在送到遊戲 server 的途中還是有可能被第三方的機器修改。這些「cheat proxy」可以在網路封包中注入「命中」的訊息而不被 VAC 徵測到(「中間人」式的攻擊法)。

網路延遲與 lag 補償建立出似乎不合真實世界邏輯的悖論。例如,你可能在已經完全隱蔽、無法被看到的情況下被對手擊中。這是因為 server 把你的 hitbox 移動回之前的位置,那時你仍暴露在攻擊者的視野中。一般來說,這種不一致的問題無法解決,因為有相當緩慢的封包。在真實世界中,你不會注意到這個問題,因為光(封包)傳遞的這麼快,你跟你周圍的每個人在當下都看到同一個世界。

網路圖表
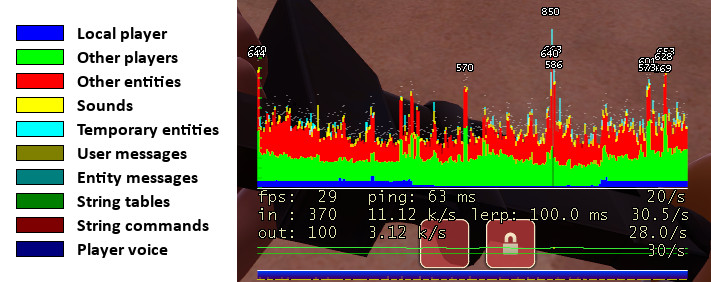
Source 引擎提供一些工具來檢查 client 的連線速度與品質。最受歡迎的是網路圖表,可以用 net_graph 2 或 +graph 來啟用。流入的封包以由左至右的移動細線條表示,每一行的高度代表封包的大小。 如果線段之間出現間隙,就表示封包遺失或是不在正確的順序到達。線段以顏色區分它們所包含的資料。

在網路圖表的下方,第一行顯示你目前的 FPS、平均的延遲時間,以及當下的 cl_updaterate 值。第二行顯示最後一個封包(snapshot)的大小(以 Byte 為單位)、平均流入頻寬,以及每秒接收到的封包數。第三行的資料相似,只是資料來源是流出的封包(user command)。


最佳化
預設的網路設定是針對在 Internet 上的專屬主機進行遊戲的設計。這樣的設定在大多數 client/server 端的硬體配備與網路配置能取得平衡點,使之能運作良好。 對於在 Internet 上進行的遊戲,client 端唯一該調的變數是「rate」,它決定了你的網路連線中有多少可用的頻寬(以 byte/sec 為單位)。較佳的設定數據如下:modem 使用者設為 4500、ISDN 使用者設為 6000、DSL 以上的使用者設為 10000。

在高效能的網路環境中,client 與 server 都具備必須的硬體資源,就可以調整平寬與 tickrate 設定,以獲得更好的遊戲精準度。增加 server 的 tickrate 通常會提高移動與射擊的精準度,相對耗費更多的 CPU 運算成本。一個設定 tickrate 為 100 的 CS:S server 會比用預設 tickrate(值為 33)的 server 多 3 倍的 CPU 負荷。這會導致嚴重的計算延遲、尤其是很多人在同一時間射擊時。不建議遊戲 server 的 tickrate 值超過 66,來保留必要的 CPU 資源以備不時之需。

如果 server 用較高的 tickrate 運作,只要所需的頻寬(rate)夠用,client 端可以增加它們的 snapshot 更新頻率(設定值:cl_updaterate)和 command 頻率(設定值:cl_cmdrate)。snapshot 的更新頻率受限於 server 的 tickrate,server 無法在每個 tick 送兩個以上的更新資訊。所以,如果 server 的 tickrate 為 66,client 端的 cl_updaterate 最高為 66。如果你增加 snapshot 的頻率而遇到封包遺失或堵塞,你就必須調降這個數值。在增加 cl_updaterate 的同時,你也可以降低畫面的 interpolation 延遲(cl_interp)。預設的 interpolation 延遲為 0.1 秒,起因於預設的 cl_updaterate 20 這個設定。畫面的 interpolation 延遲讓移動的玩家比固定不動的玩家多了些微的優勢,因為移動的玩家可以早一點點看到他的目標。這種影響無法避免,但卻可以透過調降畫面 interpolation 延遲來減低影響。如果兩個玩家都在移動,則畫面延遲同時影響雙方,沒有人有這類優勢。

snapshot rate 與畫面 interpolation 延遲的關係如下:

Source Engine v7 (CSS - HL2DM)
畫面 interpolation 延遲 = cl_interp_ratio / cl_updaterate
舉例來說,如果 client 端每秒收到 66 個更新資訊,interpolation 的比率是 2,那麼畫面 interpolation 延遲會是 0.03 秒。這樣畫面 interpolation 延遲就從 100ms 掉到 30ms。cl_interp 在 Source Engine v7 當中被停用,你需要使用 cl_interp_ration 與 cl_updaterate 來設定畫面 interpolation 延遲。把 cl_interpolation 設為 0 來完全移除畫面 interpolation 延遲會無法運作,且造成跳 tone 的動畫效果,命中偵測也會很糟。

Source Engine v14/v15 / Orange Box Engine (TF2 - DoD S) + Left 4 Dead Engine
cl_interp = cl_interp_ratio / cl_updaterate
舉例來說,如果 client 端每秒收到 66 個更新資訊、interpolation 的比例是 2,你可以把 cl_interp 設為 0.03。這樣你的畫面 interpolation 延遲就從 100ms 降低到 30ms。在這個例子中,cl_interp_ratio 是用來「限制」cl_interp 的值。在 Oragne Box 引擎中,你無法關掉畫面 interpolation 延遲。

小技巧

  • 除非你完全知道你在幹麼,不然不要更改 console 的設定。
    • 如果 server 或網路負荷不了的話,大多「高效率」的設定會導致徹底的反效果。
  • 不要關閉畫面 interpolation 和 lag 補償。
    • 這樣作不會提昇移動或射擊的精準度。
  • 對某個 client 而言的最佳化設定,可能無法適用於其他 client。
    • 在還沒有在你的系統上驗證之前,不要用其他 client 的設定。
  • 如果你在遊戲或 SourceTV 中用「第一人稱」觀看某個玩家,你看到的不完全是玩家看到的畫面。
    • 觀眾看到的遊戲世界是沒有 lag 補償的畫面。

2011-06-05

Source Multiplayer Networking [上]

原文網址:http://developer.valvesoftware.com/wiki/Source_Multiplayer_Networking
備註:下列譯文可能已經與原文網址所載有所差異,偏偏我也忘記是哪時候開始抓這篇下來翻譯的了...... 囧>


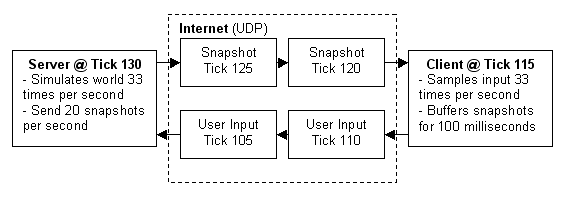
底層使用 Source Engine 的多人遊戲是使用 Client-Server 的網路架構。通常 server 是在一個專用的主機上運作,負責模擬出遊戲中的世界、掌控遊戲規則、以及處理玩家輸入。client 則是玩家的電腦,會連上遊戲 server。client 跟 server 之間的通訊模式是以高頻(每秒 20~30 個)傳送小資料量封包。client 接收 server 端傳來當下遊戲狀態的資料然後產生影音,都是靠這些微小的資料更新。client 也會對輸入裝置(鍵盤、滑鼠、麥克風等)作取樣,然後把這些輸入的取樣數據傳回 server 以作進一步處理。client 只跟遊戲 server 作資料傳輸,而不是像 p2p 應用程式那樣互相傳輸。跟單人遊戲不同,多人遊戲必須處理各種封包傳輸所產生的新問題。

網路頻寬是有限的,所以 server 不能在遊戲中世界有所改變時,就送一個新的變更封包給所有 client。取而代之的方法是,server 將現在遊戲世界的狀態以固定頻率擷取 snapshot,然後將這些 snapshot broadcast 給所有 client。client 跟 server 之間的封包傳遞一定會花掉一些時間(例如 ping 所得的時間)。這表示 client 的時間永遠會比 server 的時間晚上一點點。再者,client 端輸入裝置的資料封包在回傳 server 時也會有延遲的狀況,所以 server 正在處理的使用者指令已經是一段時間前所發出的。更麻煩的是,每個 client 的 framerate 跟其他背景程式產生的流量,會導致不同的網路延遲量。網路延遲越嚴重,server 跟 client 之間時間差造成的邏輯問題也會越嚴重。在節奏快速的動作遊戲中,即使是幾個 ms 的延遲,也會讓遊戲有 lag 的感覺;這會讓你很難 K 到其他玩家、或是對移動中的物體作動作。除了網路頻寬限制跟網路延遲外,封包遺失也會造成遊戲的資訊遺失。


為了對付上述這些議題,Source Engine 使用許多技術來解決、或是讓玩家感覺不到這些問題。這些技術包括資料壓縮、interpolation、預測、lag 補償。這些技術細節環環相扣,在某個系統做的改變可能會影響另一個系統。本文會描述這個系統的功能、以及它們如何一同運作。

網絡基礎
server 是以連續不斷、稱為 tick 的時間間隔來模擬出遊戲時間。在預設狀況下會以 66 tick/sec 運作,但 MOD 可以指定它們自己的 tickrate。以 CS(Counter-Strike)為例,Source 使用 33 tick/sec 這種較低的 tickrate 來降低 server 的 CPU 負荷。在每個 tick 的時間裡,server 處理使用者輸入的指令、執行一個物理模擬步驟、檢查遊戲規則、並且更新所有物件的狀態。經過一個 tick 的運算後,server 會依照需要,將遊戲中的世界現況作一個 snapshot、並傳送給需要的 client 端。較高的 tickrate 會增加模擬的精準度,但無論 server 還是 client 也都需要更強力的 CPU 以及更大的頻寬來配合。server 的管理者可以在 command line 下 -tickrate 指令來覆蓋預設的 tickrate。但是 tickrate 改變可能會讓 MOD 無法於預期般運作,所以不建議這樣作。

client 通常只有有限的頻寬。在最糟糕的情況下——用 modem 的玩家——網路速度沒辦法超過 5~7 KB/sec。如果 server 試圖以更快的更新速度傳送資料給 client,必然會發生封包遺失的狀況。因此,client 必須用設定 rate 參數來告訴 server 本身的網路頻寬(單位為 bytes/sec)。這對 client 而言是最重要的網路相關參數,設定正確才能有理想的遊戲體驗。client 可以改變 cl_updaterate 來確保 snapshot 的頻率(預設值為 20),但是 server 的更新速度並不會因此高於 tick 的設定值、或是超過 client 的 rate 限制。server 的管理者可以用 sv_minrate 和 sv_maxrate 限制 client 要求的資料頻率(單位為 byte/sec)。snapshot 的頻率也可以用 sv_minupdaterate 和 sv_maxupdaterate 來設定上下限(單位為 snapshot/sec)。

client 以 server 的 tick 頻率從輸入設備取樣、製造出 user command。user command 基本上是當下鍵盤與滑鼠狀態的一個 snapshot。但並不是每一個 user command 都會送封包到 server,而是以一個固定的頻率(通常是 30/sec)送出這些 command 封包。這意味著兩個或兩個以上的 command 是裝在同一個封包內送出去。client 可以用 cl_cmdrate 增加送出 command 的頻率。這會加強操作回應的靈敏度,但也需要更多的頻寬。

遊戲的數據使用 delta compression 來壓縮,以減輕網路負荷量。這表示 server 不會送出整個世界的 snapshot,而是最後一次已確認變更之後的改變(delta snapshot)。每一個 server 跟 client 之間傳遞的封包都會附加 ack 數字來保持追蹤這些資料串流。通常完整(非 delta)的 snapshot 只有在遊戲開始、或是 client 遺失長達數秒的封包時才會傳送。client 可以用 cl_fullupdate 來要求完整的 snapshot。

系統回應的靈敏度、或著說「使用者輸入」到「遊戲世界做出明顯回應」的時間,取決於很多因素,包括 server/client 的 CPU 負荷量、模擬的 tickrate、資料擷取的頻率、以及 snapshot 更新速度,不過主要因素還是卡在網路封包傳遞的時間。client 送出使用者的指令→server 做出回應→client 接收到 server 的反應,這段時間稱為 latency 或是 ping(或往返時間)。低 latency 在玩多人的線上遊戲是一個很大的優勢。像「預測」以及「lag 補償」等技術,試著把這個優勢壓到最低,使網路速度比較慢的玩家也能跟其他玩家公平競爭。當有足夠的頻寬跟夠力的 CPU,調整網路設定可以讓你得到比較好的遊戲體驗。我們建議保持預設值,因為不適當的改變可能弊多於利。


Entity interpolation
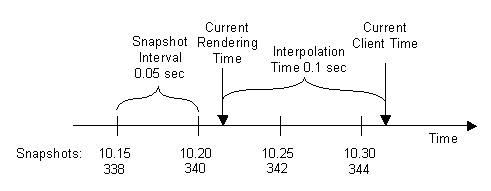
在預設情況下,cleint 每秒會收到 20 個 snapshot。如果遊戲世界中的物體只在 server 傳回的位置顯示,則移動的物體跟動畫看起來會很跳 tone。遺失的封包也會導致明顯的問題。解決這個問題的技巧是回到過去的遊戲時間來繪製,程式會從最後兩個接收到的 snapshot 來 interpolate 出連續性的位置與動畫。 這種技術稱為 client 端的 entity interpolation,預設值是(cl_interpolate 1)為啟動狀態。以每秒 20 個 snapshot 來計算,大概 50ms 就會收到一份更新資料。如果把 client 端的繪製時間回溯 50ms,那麼就可以用最後收到的兩個 snapshot 來作 interpolate。Source Engine 延遲(回溯)100ms 來計算 entity interpolate (設定為 cl_interp 0.1)。這樣作的話,即使少了一個 snapshot,也還是有兩個有效的 snapshot 可以作 interpolate。下圖是 snapshot 到達的時間軸:

client 最後接收到 snapshot 的時間是 10:30(第 344 個 tick)。clinet 的時間以這個 snapshot 及 client 的 frame 頻率持續地增加。如果要繪製一個新畫面的 frame,則描繪的時間點會是當下的時間 10.32 減去 0.1 秒的 interpolate 延遲時間,在這個例子當中就是 10.22。所有的 entity 跟動畫會依比例從 340 與 342 個 tick 中計算 interpolation。

由於我們設定 100ms 的 interpolation 延遲,所以即使 342 的 snapshot 因為封包遺失的關係而沒有收到,interpolation 還是可以透過 340 跟 344 計算得出來。如果超過一個 snapshot 遺失,interpolation 就因為歷史緩衝區的 snapshot 用完而無法運作。在這種情況下就會以目前已知的 snapshot,用簡單的線性 extrapolation(設定值:cl_extrapolate 1)來計算。extrapolation 只能在 0.25 秒內的封包遺失才能運作(設定為 cl_extrapolate_amount),如果超出這個範圍就會產生預測上的誤差。

interpolation 會導致畫面固定「lag」了 100ms,即使你就在 listen server(server 跟 client 在同一台電腦)上頭玩遊戲。所以,如果你開啟 sv_showhitboxes,會用 server 的時間來顯示玩家的 hitbox,這表示它們會比玩家 model 的時間往前了 100ms。這不代表你必須在瞄準其他玩家時,因為 client 的 interpolation 導致 server 端做 lag 補償,而必須校正這個誤差。如果你在 listen server 上關掉 interpolation(設定值為 cl_interpolate 0 以及 cl_lagcompensation 0),hitbox 顯示的值就會跟玩家的 model 相符,但是動畫跟物體移動會變得緊張兮兮的。

警告:如果在同一時間中關閉 lag 補償( 設定值:cl_lagcompensation 0 )卻開啟 interpolation,會導致預期外的結果。

2007-04-08

Hub, Switch, Bridge, Router 比較

大概三四年前,在系站上轉錄這篇文章(還不就為了吵架 \囧/);前幾天又在 ptt 上頭看到類似的問題,所以挖出來重貼。今天胡亂翻到分散式系統課本的 network 章節,就想說那也順便把這篇給 web 化吧。

念 網路的東西很麻煩,因為東西很多很雜又很亂,當年看到 P 結尾的名詞就頭大,不是說用 TCP/IP 嗎?那為甚麼還有啥 ARP、ICMP、SMTP、SNMP、HTTP,萬一碰個 router 或是高階 switch,又是一堆 xxP....... [暈],這些還不夠,還會扯到一堆 802.x 的東西...... [倒地]。單靠自己囫圇吞棗 + 週期性懶散,結論就是:還是寫程式好 \囧/。不過當網路的東西念通了、能把那些 P 分層別類安頓好,事情就會變得美妙。從 y2k 到現在,似乎也只有 RG-58 消失,RJ-45 的接頭依舊是「白橙橙白綠藍白藍綠白綜綜」,TCP/IP 還在、而且 IPV6 離一般人很遙遠。是多了一些東西,但是跟寫程式比起來,可少得多了.......

喔喔喔... 回歸主題 [毆飛]

----------------
資料來源:《Cisco 路由器設定 (Managing IP Network witch Cisco Routers)》 p.36-39,O'Reilly 1998.12 初版,ISBN:957-98213-7-2。

集線器、橋接器、Switch 與路由器
在討論路由器的放置地點之前,先確定你是否需要一台路由器。能不能用 Switch(交換器)或 Bridge(橋接器)之類的設備代替?通常網路公司的業務員不會回答這類的問題,但每種設備在網路中都有獨特的地位。你必須了解它們各自的特性,尤其是他們的弱點。

最 簡單的網路設備就是集線器(Hub),應該也是網路上最常見的機器。一般網路如 Ethernet,Token Ring,或 FDDI 都會有 Hub,選購安裝都沒有什麼學問。我們就略過不談。Hub 的等級和價格沒太大差別,主要是有沒有操作界面。但 Switch,Bridge,和路由器就完全不是這麼回事了。

幾年之前,還有人在爭論網路是該透過 Bridge 還是該透過路由器連接。Bridge 陣營堅持路由器太複雜,速度太慢,設定維護太困難;路由器陣營則預測網路會大幅成長,Bridge 將無法應付。當然,路由器最後佔了上風,網路成長的規模出乎每個人的意外。路由器的可擴充性(Scalability)是 Internet 成長的動力。

為什麼 Bridge 的擴充性不夠?這牽涉到 Bridge 本身的運作原理。當一台Bridge 收到來自網路的框包(frame),會檢查框包內的目的地位址,和自己知道的地址比對;找到符合的位址之後,它會決定是否傳送這個框包到目的地所屬的網路 區段,或是轉送到目前目的地中途的區段。如果 Bridge 知道框包是來自和目的地同樣的區段,它會忽略這個封包,因為目的地自己會接收。

如果 Bridge 不知道目的地位址,它會假定目的地可能在任何地點,直接傳送框包。如果目的地傳回一個回應訊息,Bridge 會根據訊息中的位址加在自己的位址紀錄中。所以 Bridge 是根據收到的框包位址來判斷網路組成的架構。

這個程序就是 Bridge 運作的核心。但某些框包是 Bridge 必須送到每個地方的,就是 Multicast(多址傳送)與 Broadcast(廣播)框包。由於網路上每台機器都必須收到這些框包,意思是網路上會充斥(flooded)這些框包。

Broadcast 和 Multicast 類型的框包限制了 Bridge 網路的擴充規模。當網路上的機器數量增加時,需要廣播的框包也隨之增加。平均來說,一台機器每十秒送出一個廣播,如果網路上有 1000 台電腦,平均每秒就有 100個廣播在流竄。如果有十萬台機器,情況將難以想像!

佔據頻寬並非廣播的唯一問題。因為每台機器必須時時檢查廣播框包的內容,所以會透過中斷處理。如果一直造成中斷,機器效率會慢下來,網路協定堆疊也會難以運作。

難 道機器每十秒一定要送出廣播嗎?想想廣播與多址傳送的應用情況。在IP 協定裡面,廣播是應用在位址解析(ARP,Address Resolution Protocol),路由更新,以及 rwho 之類的服務。Multicast 的應用功能大致差不多,但相對 Bridge 構成的網路來說,Multicast 和 Broadcast 沒什麼差別,反正都是要充斥整個網路。有些 Multicast 和 Broadcast 封包是定時傳送的,以 rwho 和一些路由協定資訊來說,大約每 30 秒會送出一次。

但 rwho 在這個週期之下只能送出一個封包,某些路由協定如 RIP 可以送出許多封包。對一個大型網路來說,可能一次有 10 個封包。

其 他協定對 Broadcast 和 Multicast 傳輸也有一些影響。AppleTalk 這種協定在進行資源搜尋,位址指定,或路由等動作時,會大量使用 Multicast 和 Broadcast。Novell 的 IPX 協定在服務宣告與資源搜尋時也有類似的傾向。

看以上的敘述,你不得不相信,每台機器十秒一個框包算是相當保守的估算,如果加上其他稀奇古怪的協定,產生的框包傳輸絕對不只此數。

難道路由器就能擺脫這些問題嗎?路由器的擴充性是否比 Bridge 來得好?要回答這個問題,首先讓我們看看路由器的原理。

路由器採取的做法
Bridge 在決定是否轉送框包時,是根據目的地的硬體位址。如果不知道目的地位址,或是確定框包前往的區段不在來源區段,就進行轉送。路由器傳送封包時的決定過程很類似,差別在於路由器根據的是網路層位址,而非硬體位址。但這不是唯一的差別。

真 正的差別在於網路位址是由人來指定的。原則上,具有共同 prefix 的位址都屬於同一個網路。相對上,硬體位址是製造廠商決定的,不管網路的實際配置。考慮實際的網路配置,可以增進資訊聚集(aggregation)的能 力。一個 1000 台主機的網路上的 Bridge 可能要追蹤 1000 個地點才能做出決定,但一台路由器只須追蹤 10 個以下的位址就夠了。這就是路由器高效率的主因。

資訊聚集的能力,使得路由器比 Bridge 具有更強的擴充性,但還有其他因素。Bridge 必須隨時注意網路區段的每個封包,因為它必須確定封包的目的地位址來決定是否傳送。路由器不需要隨時注意每個封包,因為封包傳送者已經決定了封包是否要轉送。如果傳送者知道目的地不在本身的區段,就利用路由器本身的硬體位址當作目的地位址,直接傳送給路由器。所以路由器只需要注意直接傳給它的封包,大大降低了路由器處理的流量。

Routing 的可擴充性還有更重要的因素。Bridge 必須傳送所有的Broadcast 和 Multicast 封包,但路由器採取不同的做法。因為路由器知道網路的實際配置,它會建立廣播網域(Broadcast domain),這只是網路的一部分,但網路上所有的機器都可以看到廣播封包。除非特別設定,否則路由器不會隨便傳送廣播封包。例如,你可以設定一台路由 器轉送 BOOTP 或 DHCP 的廣播給遠端伺服器,傳送 IP Multicast 封包給已登錄的主機。除了節省 Broadcast 和 Multicast 的傳輸之外,路由器在其他方面也可以減低頻寬的使用量。

除此之外,如果路由器收到一個無法傳送目的地的封包,它會丟棄(drop)這個封包,並回應一個訊息給寄出封包的主機,表示傳送失敗。

總結來說,路由器的擴充性是由於下列幾個因素:
  • 由於網路位址是配合實際配置來指定的,它具有高度的資訊聚集能力。
  • 它不必隨時注意區段上的每個封包。
  • 它會建立廣播網域,減少不必要的 Broadcast 和 Multicast 封包傳送。
  • 它會丟棄不明位址的封包,減少頻寬的浪費。
路由器與 Switch
路由器顯然比 Bridge 優越,只是 Bridge 不需要複雜的設定程序,也沒有人會為 Bridge 設定特別寫一本書。由於電腦硬體的速度越來越快,反而網路的頻寬成為新的問題,這就是 Switch 出現的背景。

Switch 絕大部分都是應用在 Ethernet 上(目前 Token Ring 與 FDDI switch 也日漸普遍),它透過分散頻寬的方式增加頻寬的使用效率。你可以更換硬體增加頻寬,例如將 10Mbps Ethernet 換成 100Mbps Fast Ethernet,但你得同時需要更換新的集線器,網路纜線與網路卡,這是一筆不小的花費。

Switch 扮演了一個特殊的角色。在一個分享的網路區段上,每台主機都是碰撞網域(Collision Domain)的一部分,因為 Ethernet 的傳輸會互相爭奪頻寬導致碰撞。路由器有能力縮減碰撞網域的範圍,但成本太高,而且設定複雜。以一個連接 24 個 Ethernet 區段的高速路由器來說,大概需要 10 萬美金。但一台 24-Port 的同級 Switch 只需要 8 千美金左右。那為什麼不乾脆把路由器甩在一邊,全部都用 Switch 就好了?一旦你明瞭Switch 運作的原理,答案就很明顯了。讓我們先看看 Switch 工作的方式。

當 Switch 收到一個框包,它必須判斷目的地在網路上的位置。Switch 檢視框包內的目的地硬體位址,檢查轉送表,如果找到符合的資料,就將框包送往表上指定的埠。如果找不到,它就將框包送往除了來源之外的每一個埠,希望收到 的目的地會送出一個回應,讓 Switch 更新本身的轉送表。廣播與 Multicast 都送往每個埠。

----------------
另外 p.40 頁說,switch 說穿了,就是一個多 port 的 Bridge
其他的沒啥好提的,所以就省略不 post 了