2011-09-06

App Engine 1.5.2 版發佈

原文網址:http://googleappengine.blogspot.com/2011/07/app-engine-152-sdk-released.html

server 產能的更新
  • 可調整的 Scheduler 參數 - 正如之前討論過,我們推出了兩款 scheduler 旋鈕(好吧,實際上看起來比較像滑動軸),讓你能控制有多少 instance 在 application 上執行的參數。現在,你將可以設定 panding latency 的最小值、以及閒置 instance 的最大量。

Datastore 的更新
  • 進階 query 計畫 - 我們移除了爆量索引的需要、也減少了許多 query 要自訂 index 的需求。在許多狀況下 SDK 會建議更佳的索引方式,接下來的文章也會介紹如何進一步最佳化。
  • namespace 層級的 datastore 統計資料:現在除了取得全部的 datastore 統計資料,我們也提供一個新的選擇,讓你可以以 namespace 來查詢。

Task Queue 的更新
  • 新的 Task Queue 細目頁面——我們改寫了 Administration Console 裡的 Task Queue 細目頁面,提供了執行中的 task 的更多資訊。你現在可以看到排隊中的 task、有效承載量、以及前一個執行 task 的資料。
  • 1MB 的 Pull Task 容量——對於容量大小的限制,我們的信念就是:只能變得越來越大!所以,在這個版本當中,我們把 Pull Task 的容量變成 1MB。
  • Pull Queue 時效變更——針對 Pull Queue 我們推出了新的 method,如果當初設定的時效不足時,讓你可以將現有的 task 延長時效。

最後,我們有一些令人振奮的消息是關於實驗中 Go 執行環境。雖然 Go 仍然在實驗階段,但從 1.5.2 之後,Go 將可以存取所有 HRD 的 application。

一如往常,也有一些小功能與錯誤修復,在我們的版本更新紀錄當中可以找到完整的清單(Python 版,Java 版)。我們期待在論壇當中看到您的回饋意見與問題。

2011-09-04

整合 GMail 帳號

我有四個常用的 GMail 帳號。

當然,GMail 早就不是邀請制了,甚至自己弄個 Google Apps,要有幾個帳號都不是問題。事實上,因為 Google 的 service 用得有點兇,從 GMail、Blogger、Reader、Sites、WebMaster、譯者工具包還有賺錢用的 AdSense,我還寧願只用一個帳號就滿足全部需要。

大多數的 service 的確可以做到,像 Blogger 這種寫作類的 service 都有提供其他作者協同寫作的功能、Reader 用匯入匯出的功能解決,剩下的 WebMaster 跟 AdSense 偶爾上去看一看(似乎也能開放給其他帳號,沒細究),倒也還過得去。

不過 GMail 就沒這麼簡單了,總不能用公司的帳號收信、卻用私人的帳號回信吧?所以之前的作法是同時開 Chrome 跟 Firefox,搭配無痕/私密瀏覽來解決......

實在有夠土砲的...... Orz

後來經高人指點,發現 GMail 早就想到這點了,還提供了兩個招數......

萬用基本招:POP + Send mail as
GMail 裡頭要把 A 帳號的信都轉到 B 帳號有兩種方法。第一種是選擇轉寄(Forwarding)、第二種是透過 POP3 取得信件。這裡建議是用 POP3 的方式,步驟如下:
  • 進入 A 帳號,將「POP 下載(POP Download)」的功能開啟。
  • 進入 B 帳號,在「從其他帳戶取得郵件(check mail using POP3)」新增一個帳號。這裡要注意一點,如果 A 帳號不是 xxx@gmail.com,而是由 Google Apps 提供的,記得在「使用者名稱」輸入完整的 email 帳號。另外 POP 伺服器就輸入「pop.gmail.com」、通訊埠選擇「995」
設定完成後,系統就會開始到 A 帳號檢查有無信件,有的話會抓回來並掛上對應(可設定)的標籤。

如果 Google 只做到這邊,那也不過就是功能稍微強一點 web 版的郵件軟體。重點在於「Send mail as」的功能,這功能在設定完「POP 下載」應該就會出現,也可以獨立設定。這是幹什麼的呢?它可以讓你用 B 帳號登入寄信,但是收信人看到的寄信者卻是 A 帳號。

如此,透過 POP 將另一個帳號的信彙整進來、寄信的時候可以用指定的帳號寄出去,事情解決了,萬歲! \囧/

萬能大絕招:Grant access to your account
萬用基本招雖然解決了,可是總覺得還是哪裡不滿足。最根本的問題是通訊錄:A 帳號的通訊錄得透過匯入匯出的方式才能帶到 B 帳號(雖然說回信之後會自動建立通訊錄),而且很容易就會變成公私不分的大雜燴。再者就是信件得依賴標籤的功能來區分,看/找起來並不是那麼快樂。有沒有更簡單的方式呢?

當然有!

在 A 帳號的「授權這些使用者存取我的帳戶(Grant access to your account)」增加 B 帳號的資訊,過一段時間(號稱半個小時)之後重新登入 B 帳號,就可以點選畫面右上角顯示帳號的地方,選擇「切換帳號」會出現 A 帳號,再點下去會另外開一個視窗...... YES! 直接變成 A 帳號登入的畫面了!

是的,除了沒有 Buzz、Chat、Calendar 這些 mail 以外的功能,其餘畫面操作跟 A 帳號登入時一模一樣。A、B 帳號可以同時掛在同一個瀏覽器底下,而且不用知道/輸入 A 帳號的密碼。另外,要同時代管幾個帳號也都不是問題、完全不會混亂。

不過這招有個限制,就是 A、B 兩個帳號的 domain name 必須是一樣的,foo@gmail.com 跟 mail@foo.com 是無法這樣設定的。

心得感想
不管是從哪個角度來看,都是感觸良多。

從軟體開發的角度,只能說自嘆不如。當然,上頭說得這些功能並不需要什麼高深的技術或演算法,問題在於細節很多:得同時兼顧方便性與安全性、還不能造成使用上的混亂與衝突,如果連版本演進的功夫一起算下去,Google 在軟體架構設計上真的是很可怕...... Orz

從評論軟體的角度,只能說,Google 始終展現了「不怕你用」的恢宏氣度。在那個 Hotmail、Yahoo 信箱免費空間大小了不起 50、100MB,GMail 直接給 1GB 的容量、一年後變成 2GB,然後玩起「空間隨著時間慢慢增加」的噱頭,到現在 7.xGB 還在持續增長中。我有點好奇誰能在正常使用下塞滿它......

Google 也不怕你開多個帳號佔據它的資源,不但不怕,還提供了許多功能方便讓你管理眾分身。我是已經很久沒用其他 mail service 了,不知道有哪家有做到如此程度?

從另一個角度來看,Google 的功能大多悄悄無聲無息地出現,像「POP3 下載」這功能,在開放時網路上有喧囂一陣,所以還有點印象。但是這篇提到的其他功能,就根本也不知道啥時候冒出來的,更不用講 GMail 裡頭 LAB 那一卡車的東西了。

不知道這些功能,使用上也沒啥大妨礙;多了這些功能,你也不會覺得被妨礙。

又不免吐槽一下 M$,M$ 常常怕使用者不知道他做了多少改變,問題是改變之後反而不知道要怎麼用了,想回頭用舊的版本還不行(最近才遇到 Windows 2000 安裝 Skype 5.x 版會死翹翹,還好網路上還有 4.x 的免安裝版可以用 [怒]),說明文件又爛得要命,難怪 M$ 連 Office 都可以推證照制度...... Orz

最後說回行銷面,我想這篇就是受到 Google 行銷手法(個人覺得不算行銷,但是人家科班出身的都這樣講了.....)影響下的產物:

  • 「這是啥功能...... =="」 or 「最近有一批功能好便宜 [誤]」
  • 哇靠!這他 x 的超好用的啦...
  • 什麼,你居然不知道? 好好好,我教你......
於是乎,推銷員有了、教育人員有了、甚至連文件撰寫人員也有了(雖然 Google 本身的文件、即使是中文版的也不差)。Google 沒有想一次就改變全世界,甚至可能根本沒有想改變全世界,比較像是「我需要用這個,你要用也歡迎」。但是,世界改變了......

「如何吃下一頭大象?」「一次吃一口」

嗯... 還有很長的路要走...... [遠目]

2011-09-01

粗探 GWT Image 內的實做方式

GWT 當中的 Widget,大概只有 Button 的使用率大於 Image(這也難講,說不定有些人直接用 Image 作 button...... XD)。所以來探究一下 source code 寫了啥東西。

要建立一個 Image,最直接了當的用法是給它 url:
Image img = new Image("http://an.url/pic.jpg");

這裡的 url 使用相對路徑亦可,不過得注意是相對於載入這個 GWT module 的頁面就是了。

切到這個 Image(String) 這個 constructor,會發現當中做了兩件事情:
  1. 將 state 設定為新產生的 UnclippedState 物件
  2. 設定 style name 為 "gwt-Image"

設定 style name 這檔子事情有點無關緊要,忽略不管。至於 state 這個 field 是怎麼一回事?這似乎得要回頭看開頭 JavaDoc 寫的:
「The image can be in 'unclipped' mode (the default) or 'clipped' mode.」
也就是說,Image 透過 state 來決定當下是哪一種使用方式,這可以解釋為甚麼有另一個 Image(String, int, int, int, int) 的 constructor。實際去看 Image 的 method 行為,getter、setter、onLoad() 等都是由 state 負責,只有跟 event handler 有關的 method 是用 Widget.addHandler() 處理。

於是找到 Image 裡頭 State 這個 private 的 abstract class。它只有兩個 method 不是 abstract 的:onLoad(Image)、fireSyntheticLoadEvent(Image),這兩個都跟 event 有關,在這篇文章當中先略過,以免枝節太多。其餘的 abstract method 留給 ClippedState、UnclippedState 實做。

比對 ClippedState 與 UnclippedState 實做 method 的差異,差別在於 ClippedState 多了 width、height、left、top 這幾個 field,UnclippedState 在取這些值時,是直接對 Image 所屬的 ImageElement 取值,而 ClippedState 則直接回傳 field 的值。另外,如果叫用到 ClippedState.setUrl() 會將 state 切換到 UnclippedState;反之,如果叫用到 UnclippedState.setVisibleRect() 與 setUrlAndVisibleRect() 會將 state 切換到 ClippedState。

這到底在幹什麼?

回歸實際用途,ClippedState 的目的是只顯示圖片上的某個矩形區塊,所以得加上長、寬、起始位置等資訊。製造出這種效果的方法,則是靠 CSS 設定 span 的 background 來辦到。怎麼知道的呢?答案在 constructor 當中的這行:
image.replaceElement(impl.createStructure(url, left, top, width, height));

先用 ClippedImageImpl.createStructure() 製造出一個 Element 物件,然後再把原本 Image 的 element 換成這個。再仔細看一下 ClippedImageImpl 裡頭的寫法,發現它直接用最硬幹的方式設定 element 的 HTML 與 style,也難怪會抽出去自成一個 class。這說明了為甚麼 JavaDoc 強調當 clipped 與 unclipped 互換時,所有的 style 設定都會消失。

重新回到 Image,會發現這個 class 只是邏輯上的存在,為了做到 clipped/unclipped 的效果,所以透過 State 來處理;因為底層實做方式的不同,所以當物件的行為模式轉換時變更到對應的 state。而真正對應 DOM,則是 ImageElement(unclipped mode)與 SpanElement(clipped mode)。使用 Image 時哪會想到底下這麼多怪東西?好的 class 如當是也......

Image 最後還有一個 perfetch(String) 的功能,就留待下回分解了(?)


這篇是退伍後的復健治療... 所以... [遮臉]

2011-07-04

App Engine 1.5.1 版發佈

原文網址:http://googleappengine.blogspot.com/2011/06/app-engine-151-release.html


Google I/O 已經結束一個月,所以我們覺得應該再來個版本發佈了。這個月我們發佈 ProtoRPC 這個正式的 Python API;讓 SDK 有 HRD(High Replication Datastore)的功能,協助開發者更能理解同步 model;另外增加了 Channel API、以及一些好東西。列舉如下:

service 變更

  • 地理定位 header:App Engine 現在會在每個 client 的 request 當中夾帶 header,來盡可能地分辨是哪一個國家發出的 request。「X-AppEngine-country」這個 header 可以讓你依照使用者的所在地來客製化內容。我們希望這代表使用者不用再到「你的國家」下拉選單當中選擇。

更新 Java 和 Python 的 API

  • Channel API(支援 Presence):現在你可以為你的 application 設定內建的 service,來偵測使用者的 presence。這讓你可以在使用者連線或斷線時作對應的行為。
  • Image API(支援 WebP):Image API 現在支援 WebP 格式。WebP 是一種新的圖像格式,Google 在今年初的時候開放原始碼。這個格式是用破壞性壓縮的方式,可以比 JPEG 格式檔案小 39% 、卻提供相同的畫質。

新的 Python API

  • ProtoRPC: ProtoRPC 是一個 open source 的 frame,用來建立一個良好定義、易於使用、web base 的 RPC service。雖然 ProtoRPC 跟 Google Protocol Buffers 定義 service 差不多,但 ProtoRPC 的目標是讓開發人員更容易開始定義 web base 的 service,同時允許這些 service 隨著時間改變而能逐步成型與拓展。

Datastore

  • SDK 中的 HRD:從發佈 HRD時,我們就希望能提供工具、幫助開發人員在設計 application 時了解和測試新的同步 model。1.5.1 SDK(Java 與 Python 版)可以模擬 HRD 的同步 model。這表示在設定對應的 SDK 選項後,跨 entity group 的查詢結果,偶爾會與剛寫入的資料有出入。這應該會讓你開發的過程中,處理這個同步 model 更加靈活。

(最後一段懶得翻譯 [逃])

2011-07-02

Source Multiplayer Networking [下]

輸入預測
前提假設是:有一個玩家的網路延遲為 150ms,然後開始往前移動。按下 +FORWARD 鍵的訊息儲存在一個 user command 當中,然後送到 server。user command 就會用移動的程式碼處理,玩家的角色也會在遊戲世界當中往前移動。這個遊戲世界狀態的改變,會在下一個 snapshot 更新時送給所有的 client。因此,玩家在開始行走之後 150ms 才會看到移動的變化。這種延遲狀況適用於所有玩家的行為,例如移動、武器射擊等,網路延遲越嚴重、這個狀況就會更嚴重。

玩家之間輸入與對應視覺回饋的延遲,造成一個奇怪且不自然的感覺,使得很難移動或是精準地瞄準。client 端的輸入預測(設定值 cl_predict 1)是消除這種延遲、使玩家感覺動作是即時的一種方法。與其等待 server 更新自己的位置,還不如 client 直接預測自己所下 user command 的結果。因此,server 處理 user command 的程式碼與規則,現在改由 client 端照樣處理。做完預測後,client 端的玩家會馬上移動到新的地點,但對 server 來說,那人仍然在老地方。

150ms 後,client 會收到 server 傳來的 snapshot,當中包含了之前預測 user command 產生的改變。然後 client 比較 server 計算的位置跟自己預測的位置,如果它們的值不相同,就會產生預測錯誤。這表示 client 在處理 user command 時沒有其他 entity 或是環境正確的資訊。client 就必須校正自己的位置,因為 server 有最終決定權可蓋過 client 端的預測值。當 cl_showerror 1 啟動,預測錯誤發生時 client 端就看得到。預測錯誤的校正會相當明顯,client 端看到的畫面也會亂跳。在一個較短的時間當中逐步修正錯誤(設定值:cl_smoothtime),可以較平滑地解決這個問題。平順預測誤差的功能也可以透過設定 cl_smooth 0 來關掉。

只有在 client 端與 server 端都知道同樣的規則以及物體的狀態,才有辦法預測物體的行為。但通常並非如此,因為 server 通常會比 client 知道更多物件資訊。client 只會看到一小部份的遊戲世界、以及僅夠繪製物件的資料量。因此,只能對 client 端自己控制的玩家、武器作預測。在這一點上,正確地預測其他玩家或是物體之間的交互作用,是無法辦到的。

lag 補償
在 Source 的 SDK 中可以看到 lag 補償與 view interpolation 的所有原始碼
假設一個玩家在 client 端時間 10.5 的時候開槍打一個目標。開槍的訊息會裝在一個 user command 當中,然後送到 server 去。當這個封包在網路上傳輸時,server 持續運作遊戲世界,所以目標可能移到不同的位置。這個 user command 在 server 時間 10.6 的時候到達,但即使玩家已經確實瞄準這個目標,server 還是可能會判定沒有命中。可以藉由 server 端的 lag 補償(設定值:sv_unlag 1)來校正這個誤差。

lag 補償系統會保留現在所有玩家過去一秒位置的歷史紀錄(可以用 sv_maxunlag 來設定間隔長度)。如果 user command 被執行到,server 會用下面的公式預測這個 command 是什麼時候執行的:
command 執行時間 = server 目前時間 - 封包往來時間 - client 端 interpolation
然後 server 會把所有玩家——也僅限玩家——移回 command 執行時的位置。這樣 user command 執行時,命中偵測就會正確。而在 user command 執行完後,玩家就會恢復到原來應該在的位置。
注意:因為算式中包含 entity interpolation,所以拿掉 entity interpolation 可能會導致預期外的結果。
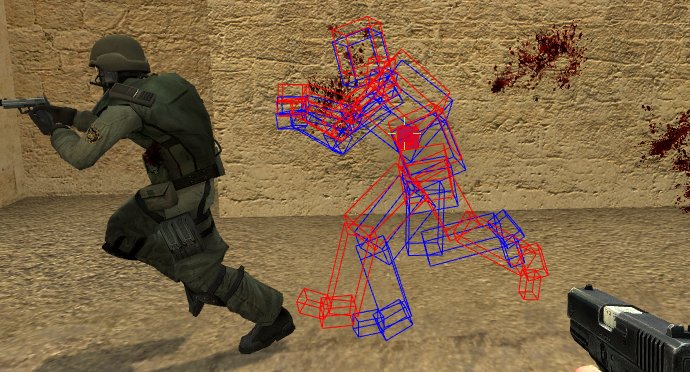
在 listen server 上,你可以設定 sv_showimpacts 1 來看到 server 與 client 不同 hitbox:


上頭這畫面是在一個用 net_fakelag 設定 200ms 延遲的 listen server 上擷取下來,此時 server 剛剛確認命中。 紅色 hitbox 顯示 client 在 100ms 之前看到的目標位置。在那之後,目標持續往左移動,直到 user command 到達 server。在 user command 到達後,server 用 command 執行時間作估算,將目標位置還原成藍色 hitbox 的地方。server 計算射擊的軌跡、確認擊中(client 看到噴血的效果)。

client 跟 server 的 hitbox 不會完全相符,這是因為時間測量產生的些微誤差。對於快速移動的物體來說,即使只是幾 ms 的差別,也會導致幾英吋的誤差。多人遊戲中的命中檢測並沒有辦法達到 pixel 層的完全吻合,精準度的限制在於 tickrate 以及物體移動的速度。增加 tickrate 會提昇命中檢測的精準度,但需要更多的 CPU、記憶體、以及 server 與 client 之間的網路頻寬。

講到這裡,有個問題就浮現了:為甚麼 server 上的命中檢測這麼複雜?往回追溯玩家位置與命中確認的精準度誤差,可以在 client 端以 pixel 等級的精準度處理得更輕鬆。client 端只要告訴 server 哪個玩家在哪裡被打中的「擊中」訊息就可以了。不過我們不能容許這種簡化的想法,因為遊戲 server 不能在這類重要的判斷上相信 client。即使 client 很「乾淨」、並有 Valve Anti-Cheat(VAC)的保護,但封包在送到遊戲 server 的途中還是有可能被第三方的機器修改。這些「cheat proxy」可以在網路封包中注入「命中」的訊息而不被 VAC 徵測到(「中間人」式的攻擊法)。

網路延遲與 lag 補償建立出似乎不合真實世界邏輯的悖論。例如,你可能在已經完全隱蔽、無法被看到的情況下被對手擊中。這是因為 server 把你的 hitbox 移動回之前的位置,那時你仍暴露在攻擊者的視野中。一般來說,這種不一致的問題無法解決,因為有相當緩慢的封包。在真實世界中,你不會注意到這個問題,因為光(封包)傳遞的這麼快,你跟你周圍的每個人在當下都看到同一個世界。

網路圖表
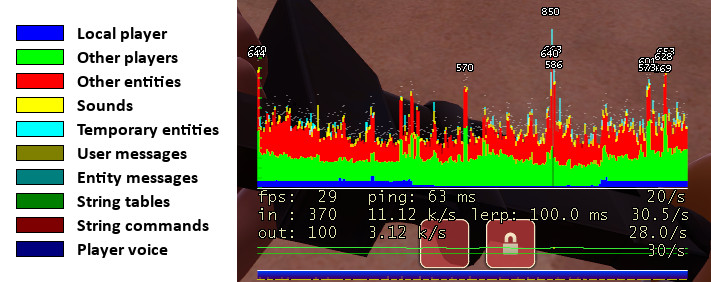
Source 引擎提供一些工具來檢查 client 的連線速度與品質。最受歡迎的是網路圖表,可以用 net_graph 2 或 +graph 來啟用。流入的封包以由左至右的移動細線條表示,每一行的高度代表封包的大小。 如果線段之間出現間隙,就表示封包遺失或是不在正確的順序到達。線段以顏色區分它們所包含的資料。

在網路圖表的下方,第一行顯示你目前的 FPS、平均的延遲時間,以及當下的 cl_updaterate 值。第二行顯示最後一個封包(snapshot)的大小(以 Byte 為單位)、平均流入頻寬,以及每秒接收到的封包數。第三行的資料相似,只是資料來源是流出的封包(user command)。


最佳化
預設的網路設定是針對在 Internet 上的專屬主機進行遊戲的設計。這樣的設定在大多數 client/server 端的硬體配備與網路配置能取得平衡點,使之能運作良好。 對於在 Internet 上進行的遊戲,client 端唯一該調的變數是「rate」,它決定了你的網路連線中有多少可用的頻寬(以 byte/sec 為單位)。較佳的設定數據如下:modem 使用者設為 4500、ISDN 使用者設為 6000、DSL 以上的使用者設為 10000。

在高效能的網路環境中,client 與 server 都具備必須的硬體資源,就可以調整平寬與 tickrate 設定,以獲得更好的遊戲精準度。增加 server 的 tickrate 通常會提高移動與射擊的精準度,相對耗費更多的 CPU 運算成本。一個設定 tickrate 為 100 的 CS:S server 會比用預設 tickrate(值為 33)的 server 多 3 倍的 CPU 負荷。這會導致嚴重的計算延遲、尤其是很多人在同一時間射擊時。不建議遊戲 server 的 tickrate 值超過 66,來保留必要的 CPU 資源以備不時之需。

如果 server 用較高的 tickrate 運作,只要所需的頻寬(rate)夠用,client 端可以增加它們的 snapshot 更新頻率(設定值:cl_updaterate)和 command 頻率(設定值:cl_cmdrate)。snapshot 的更新頻率受限於 server 的 tickrate,server 無法在每個 tick 送兩個以上的更新資訊。所以,如果 server 的 tickrate 為 66,client 端的 cl_updaterate 最高為 66。如果你增加 snapshot 的頻率而遇到封包遺失或堵塞,你就必須調降這個數值。在增加 cl_updaterate 的同時,你也可以降低畫面的 interpolation 延遲(cl_interp)。預設的 interpolation 延遲為 0.1 秒,起因於預設的 cl_updaterate 20 這個設定。畫面的 interpolation 延遲讓移動的玩家比固定不動的玩家多了些微的優勢,因為移動的玩家可以早一點點看到他的目標。這種影響無法避免,但卻可以透過調降畫面 interpolation 延遲來減低影響。如果兩個玩家都在移動,則畫面延遲同時影響雙方,沒有人有這類優勢。

snapshot rate 與畫面 interpolation 延遲的關係如下:

Source Engine v7 (CSS - HL2DM)
畫面 interpolation 延遲 = cl_interp_ratio / cl_updaterate
舉例來說,如果 client 端每秒收到 66 個更新資訊,interpolation 的比率是 2,那麼畫面 interpolation 延遲會是 0.03 秒。這樣畫面 interpolation 延遲就從 100ms 掉到 30ms。cl_interp 在 Source Engine v7 當中被停用,你需要使用 cl_interp_ration 與 cl_updaterate 來設定畫面 interpolation 延遲。把 cl_interpolation 設為 0 來完全移除畫面 interpolation 延遲會無法運作,且造成跳 tone 的動畫效果,命中偵測也會很糟。

Source Engine v14/v15 / Orange Box Engine (TF2 - DoD S) + Left 4 Dead Engine
cl_interp = cl_interp_ratio / cl_updaterate
舉例來說,如果 client 端每秒收到 66 個更新資訊、interpolation 的比例是 2,你可以把 cl_interp 設為 0.03。這樣你的畫面 interpolation 延遲就從 100ms 降低到 30ms。在這個例子中,cl_interp_ratio 是用來「限制」cl_interp 的值。在 Oragne Box 引擎中,你無法關掉畫面 interpolation 延遲。

小技巧

  • 除非你完全知道你在幹麼,不然不要更改 console 的設定。
    • 如果 server 或網路負荷不了的話,大多「高效率」的設定會導致徹底的反效果。
  • 不要關閉畫面 interpolation 和 lag 補償。
    • 這樣作不會提昇移動或射擊的精準度。
  • 對某個 client 而言的最佳化設定,可能無法適用於其他 client。
    • 在還沒有在你的系統上驗證之前,不要用其他 client 的設定。
  • 如果你在遊戲或 SourceTV 中用「第一人稱」觀看某個玩家,你看到的不完全是玩家看到的畫面。
    • 觀眾看到的遊戲世界是沒有 lag 補償的畫面。